Chạy Mô Hình Qwen 125B Với 8GB VRAM: Cơ Chế Phân Mảnh Bộ Nhớ Của Dự Án Strata
Dự án mã nguồn mở Strata (v0.1.13) ứng dụng cơ chế phân mảnh bộ nhớ lai giữa GPU VRAM (tối thiểu 8GB), RAM hệ thống (48GB-64GB) và bảng tra cứu trên SSD NVMe để chạy mô hình MoE 125 tỷ tham số Qwen3.8-Flash-Next. Hệ thống đạt tốc độ sinh văn bản thực tế từ 60 đến 95 tokens/giây trên card RTX 5070 và 100 đến 140 tokens/giây trên RTX 3090, hỗ trợ xuất sắc các tác vụ lập trình Three.js và phát triển Agent cục bộ.
Mô hình ngôn ngữ lớn (LLM) kiến trúc Mixture-of-Experts (MoE) quy mô hơn 100 tỷ tham số trước đây luôn đòi hỏi hệ thống máy chủ đám mây hoặc các cụm máy trạm doanh nghiệp trang bị nhiều card đồ họa cao cấp. Rào cản bộ nhớ đồ họa (VRAM) là nút thắt vật lý lớn nhất đối với các kỹ sư và nhóm nghiên cứu độc lập khi muốn vận hành mô hình suy luận cục bộ (Local AI).
1. Bối Cảnh Trước Khi Có Thay Đổi Này
Trong hệ sinh thái phần cứng tiêu dùng, card đồ họa cá nhân thường chỉ trang bị từ 8GB đến 16GB VRAM. Khi triển khai các mô hình mã nguồn mở quy mô trên 70B tham số, ngay cả khi áp dụng lượng hóa 4-bit (INT4), dung lượng bộ nhớ cần thiết cho riêng trọng số vẫn vượt ngưỡng 40GB.
Rào Cản Bộ Nhớ Đồ Họa Khi Vận Hành Mô Hình Cục Bộ
Khi VRAM bị tràn, các công cụ suy luận truyền thống buộc phải chuyển bớt các lớp tính toán sang RAM hệ thống qua giao tiếp PCIe. Tuy nhiên, việc hoán đổi dữ liệu liên tục giữa VRAM và RAM qua bus PCIe dẫn đến hiện tượng nghẽn băng thông nghiêm trọng. Tốc độ sinh văn bản thường tụt giảm xuống dưới 2 đến 5 tokens/giây, khiến mô hình khó có thể ứng dụng vào các tác vụ đòi hỏi phản hồi tức thì như lập trình tương tác hay trợ lý giọng nói.
- Trọng số mô hình MoE quy mô lớn vượt xa dung lượng VRAM phần cứng tiêu dùng.
- Tốc độ suy giảm nghiêm trọng khi offload sang RAM truyền thống làm mất khả năng tương tác trực tiếp.
- Chi phí đầu tư hệ thống nhiều GPU dung lượng lớn tạo rào cản tài chính đối với cộng đồng phát triển.
Do đó, cộng đồng mã nguồn mở liên tục tìm kiếm giải pháp phân bổ bộ nhớ hiệu quả hơn nhằm tận dụng RAM hệ thống mà không làm sụp đổ thông lượng xử lý.
2. Chuyện Gì Vừa Thay Đổi
Theo phân tích từ Zero Giải Thích (freedidi.com), rào cản phần cứng đối với các mô hình AI mã nguồn mở vừa được hạ thấp đáng kể với sự xuất hiện của dự án Strata trên GitHub. Công cụ này cho phép triển khai mô hình Qwen3.8-Flash-Next quy mô 125 tỷ tham số (125B) trên các dòng máy tính cá nhân chỉ sở hữu tối thiểu 8GB VRAM đồ họa, hỗ trợ đồng thời cả card NVIDIA lẫn AMD.
Cơ Chế Phân Mảnh Bộ Nhớ Lai Giữa VRAM, RAM Và Ổ Cứng NVMe
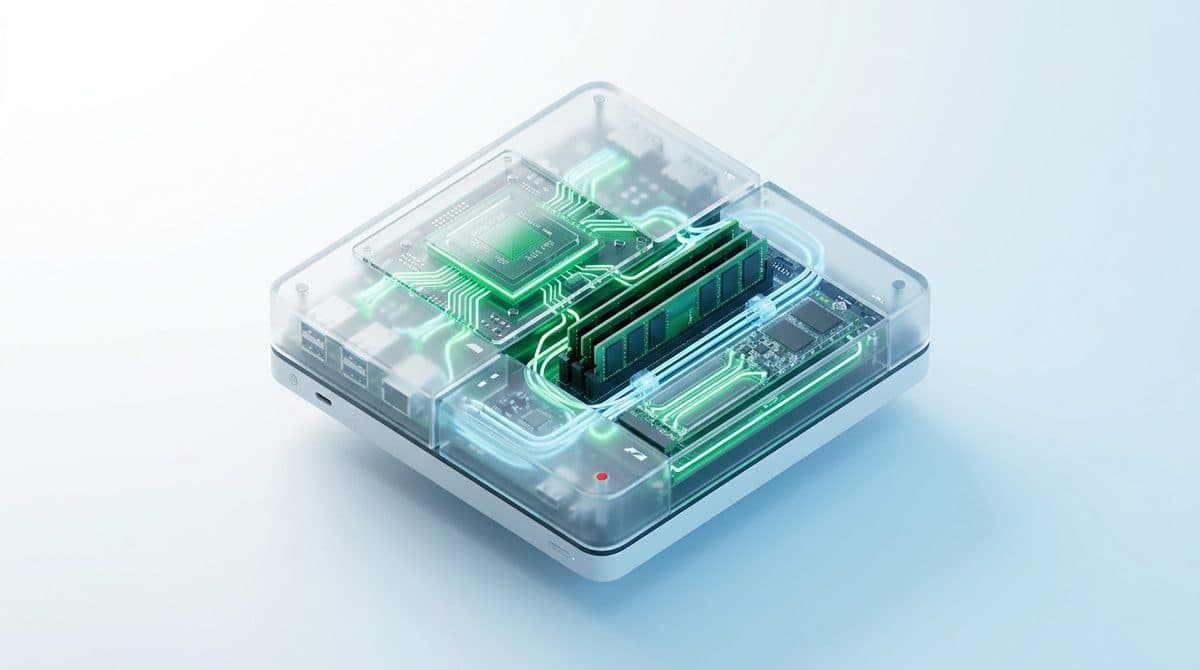
Bí quyết kỹ thuật giúp Strata phá vỡ nút thắt băng thông nằm ở kiến trúc phân mảnh dữ liệu (Memory Sharding) đa tầng, kết hợp giữa ba cấp độ lưu trữ:
- Phần cốt lõi trên VRAM: Các lớp tính toán quan trọng và cơ chế chú ý (attention mechanism) được nạp trực tiếp vào 8GB VRAM của GPU để tận dụng năng lực tính toán song song.
- Phân mảnh chuyên gia trên RAM hệ thống: Dữ liệu trọng số của các mạng chuyên gia (experts) trong kiến trúc MoE được nạp vào RAM hệ thống (yêu cầu từ 48GB đến 64GB DDR5), chỉ truy xuất các chuyên gia được kích hoạt theo ngữ cảnh.
- Bảng tra cứu trên ổ cứng SSD: Phân mảnh chứa bảng tra cứu tĩnh (lookup table) khoảng 29GB được duy trì trực tiếp trên ổ cứng SSD NVMe qua cơ chế Memory-Mapped I/O, giúp tiết kiệm bộ nhớ khả dụng mà vẫn giữ độ trễ truy xuất ổn định.
Hiệu Năng Thực Tế Và Các Định Dạng Lượng Hóa
Trong thử nghiệm thực tế trên cấu hình gồm card NVIDIA RTX 5070 (12GB VRAM), vi xử lý AMD Ryzen 5 7600 và 64GB RAM, Strata ghi nhận tốc độ sinh văn bản đạt từ 60 đến 95 tokens/giây ở hội thoại ngắn, và từ 42 đến 65 tokens/giây trong ngữ cảnh 128K tokens. Khi vận hành trên dòng card cao hơn như RTX 3090 (24GB VRAM), tốc độ xử lý có thể đạt 100 đến 140 tokens/giây.
Các định dạng lượng hóa được tối ưu hóa cho cấu hình này:
- Định dạng Q2_0: Yêu cầu 37,6GB bộ nhớ, đạt tốc độ nhanh nhất (khoảng 95 tokens/giây).
- Định dạng IQ2_XS: Yêu cầu 39,2GB bộ nhớ, được khuyến nghị sử dụng vì cân bằng giữa tốc độ (78 tokens/giây) và chất lượng phản hồi logic.
- Định dạng IQ3_XXS và IQ3_S: Yêu cầu từ 47GB đến 54,8GB bộ nhớ, hướng tới độ chính xác tương đương mô hình gốc với tốc độ từ 54 đến 66 tokens/giây.
Ngoài phiên bản gốc, cộng đồng còn phát triển biến thể mô hình Swift 1.5 của UkisAI trên Hugging Face. Bản tối ưu này áp dụng cơ chế giảm chuỗi suy nghĩ dư thừa, giúp cắt giảm 63,4% lượng token suy luận và tăng tốc độ xử lý khoảng 1,8 lần trong khi vẫn bảo toàn độ chính xác.
Thử Nghiệm Năng Lực Sinh Mã Và Trợ Lý Tương Tác Cục Bộ
Để kiểm chứng năng lực thực tế, mô hình đã được thử nghiệm với nhiều tác vụ lập trình phức tạp:
- Sinh game 3D trượt tuyết đêm bằng Three.js: Mô hình tạo thành công toàn bộ mã nguồn trò chơi 3D trong một tệp HTML độc lập, tích hợp hiệu ứng ánh sáng đêm, vật lý va chạm và âm thanh gió từ Web Audio API.
- Sinh game bắn súng góc nhìn thứ nhất (3D FPS): Tạo lập trò chơi bắn súng hoàn chỉnh trên trình duyệt với cơ chế di chuyển WASD, khóa chuột Pointer Lock, nạp đạn và AI tuần tra của đối thủ.
- Xây dựng trợ lý ảo 3D trên màn hình: Mô hình hỗ trợ thiết kế cấu trúc trợ lý ảo 3D sử dụng Electron, Three.js, nhận diện giọng nói Faster-Whisper, chuyển văn bản thành giọng nói Edge-TTS và đồng bộ khẩu hình trực tiếp.
3. Tác Động Và Rào Cản Thực Tế
Khả năng vận hành mô hình 125B ngay trên máy tính cá nhân mang lại nhiều tác động tích cực đối với hệ sinh thái phát triển trí tuệ nhân tạo:
Thu Hẹp Khoảng Cách Triển Khai Cho Lập Trình Viên Cá Nhân
Thay vì phụ thuộc vào API đám mây với chi phí tích lũy theo số lượng token, lập trình viên có thể thử nghiệm và tinh chỉnh các hệ thống Agent tự động hóa trực tiếp trên máy trạm cá nhân. Điều này đặc biệt có ý nghĩa với các dự án đòi hỏi bảo mật dữ liệu cao, xử lý tài liệu nội bộ hoặc vận hành trong mạng nội bộ cô lập.
Rào Cản Dung Lượng Bộ Nhớ Hệ Thống Và Tốc Độ Ổ Cứng
Dù rào cản VRAM đồ họa đã được hạ xuống mức 8GB, kiến trúc Strata vẫn đặt ra các yêu cầu cấu hình nhất định:
- Dung lượng RAM hệ thống: Người dùng cần trang bị tối thiểu từ 48GB đến 64GB RAM để chứa phân mảnh chuyên gia và các tiến trình nền. Máy tính cá nhân trang bị 16GB hoặc 32GB RAM sẽ không đủ khả năng khởi chạy mô hình.
- Yêu cầu ổ cứng NVMe tốc độ cao: Việc lưu trữ bảng tra cứu 29GB trên ổ cứng đòi hỏi tốc độ đọc ngẫu nhiên lớn nhằm hạn chế nghẽn I/O khi xử lý chuỗi ngữ cảnh dài.
- Độ chính xác ở mức lượng hóa sâu: Dù định dạng IQ2_XS cho tốc độ ấn tượng, việc nén trọng số sâu vẫn có thể tạo ra độ lệch nhỏ ở các bài toán suy luận trừu tượng hoặc yêu cầu ngữ cảnh đa tầng phức tạp.
4. Góc Nhìn Từ NLTECH
Sự phát triển của các kỹ thuật phân mảnh bộ nhớ như Strata khẳng định xu hướng đưa mô hình AI lớn về biên đang diễn ra rõ rệt. Đối với các kỹ sư và doanh nghiệp công nghệ tại Việt Nam, việc làm chủ kiến trúc suy luận cục bộ kết hợp giữa phần cứng tiêu dùng và mô hình nguồn mở mở ra hướng tối ưu chi phí vận hành hiệu quả, tạo nền tảng phát triển các giải pháp phần mềm và AI tự chủ có tính bảo mật cao mà không phụ thuộc hạ tầng đám mây quốc tế.