MIT Và Sakana AI Công Bố Khung SIFT: Đột Phá Đánh Giá Coding Agent Tự Hoàn Thiện Bằng Thuật Toán Xếp Hạng Bradley-Terry
SIFT là khung kiến trúc mã nguồn mở do MIT và Sakana AI công bố ngày 02/10/2026. Bằng việc sử dụng LLM Judge và mô hình thống kê Bradley-Terry để xếp hạng các bản vá mã nguồn, SIFT giúp tác tử lập trình đạt 35,1% độ chính xác trên Polyglot benchmark với tài nguyên kiểm thử tối thiểu.
Ngày 02 tháng 10 năm 2026, nhóm nghiên cứu phối hợp giữa Viện Công nghệ Massachusetts (MIT) và phòng thí nghiệm Sakana AI đã chính thức công bố khung kiến trúc mã nguồn mở SIFT (Scalable Iterative Filtering). Đây là giải pháp giải quyết trực diện nút thắt cổ chai về chi phí và thời gian đánh giá trong chu trình tự hoàn thiện đệ quy của các tác tử lập trình (AI Coding Agent), mở ra khả năng tối ưu hóa mã nguồn liên tục mà không làm kiệt quệ tài nguyên tính toán.
1. Bối Cảnh Trước Khi Có Thay Đổi Này
Trong nỗ lực nâng cao năng lực cho các tác tử lập trình tự hành, hướng tiếp cận tự hoàn thiện đệ quy (Recursive Self-Improvement) đang thu hút sự quan tâm lớn. Theo mô hình này, tác tử AI tự động sinh ra hàng loạt phương án sửa đổi mã nguồn (code patches), tự chạy thử nghiệm, phân tích lỗi và lặp lại chu trình để dần hoàn thiện giải pháp. Tuy nhiên, khi đưa vào thực nghiệm ở quy mô lớn, các kỹ sư đối mặt với rào cản nghiêm trọng về chi phí:
Nút Thắt Chi Phí Đánh Giá Mã Nguồn
- Chi phí tính toán tăng đột biến: Để xác minh tính đúng đắn của một bản vá, hệ thống phải dựng lại môi trường container và chạy toàn bộ bộ kiểm thử với hàng trăm trường hợp biên. Việc thực thi hàng nghìn lượt kiểm thử toàn diện cho mỗi vòng lặp khiến chi phí điện toán tăng theo cấp số nhân.
- Thời gian phản hồi bị kéo dài: Một chu trình chạy benchmark hoàn chỉnh trên các tập dữ liệu như Polyglot hay SWE-bench có thể tiêu tốn từ vài giờ đến nhiều ngày. Độ trễ lớn này khiến vòng lặp phản hồi của tác tử bị tắc nghẽn, làm chậm đáng kể tiến độ cải tiến thuật toán.
- Lãng phí tài nguyên cho các nhánh lỗi: Thực tế cho thấy đa phần các bản vá do tác tử sinh ra ở các bước đầu đều chứa lỗi cơ bản. Việc cấp phát toàn bộ tài nguyên máy chủ để chạy trọn vẹn kịch bản kiểm thử cho các phương án kém tiềm năng là sự lãng phí rất lớn.
Nhiều đội ngũ từng cố gắng giảm tải bằng cách chọn ngẫu nhiên một tập con các bài kiểm tra, nhưng phương pháp này thường dẫn đến hiện tượng dương tính giả, làm sai lệch định hướng của cả chu trình tự học.
2. Chuyện Gì Vừa Thay Đổi
Theo MIT & Sakana AI, thông tin chi tiết về khung nghiên cứu SIFT đã được công bố thông qua cổng nghiên cứu Sakana AI, bài báo cáo kỹ thuật từ MIT và bài phân tích trên VentureBeat. Công trình do các nhà nghiên cứu Xinghong Fu từ MIT cùng Aravinth Kulanthaivelu và Yutaro Yamada từ Sakana AI đồng tác giả, giới thiệu cơ chế lọc phân tầng kết hợp mô hình thống kê xác suất để tháo gỡ điểm nghẽn:
Cơ Chế Lọc Phân Tầng Bradley-Terry
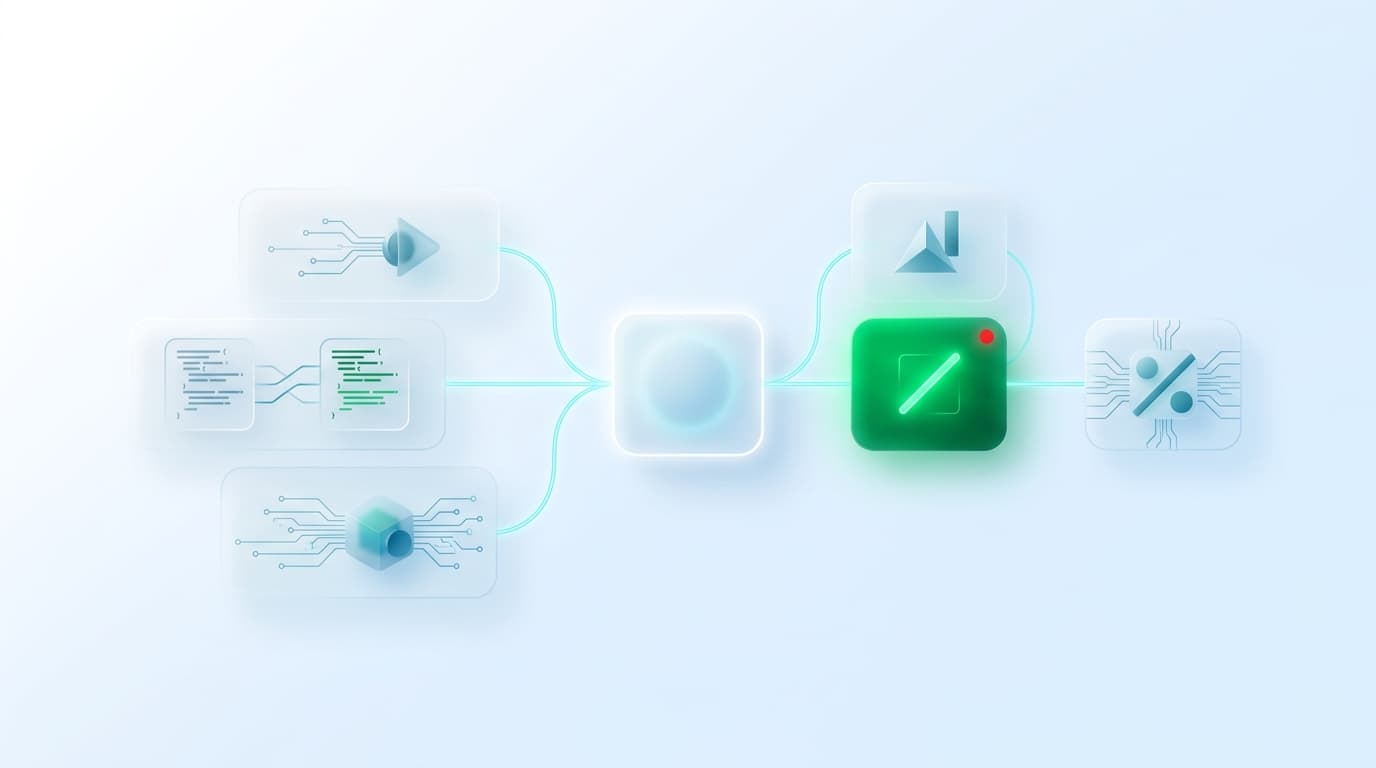
- Đánh giá cặp thông qua giám khảo AI: Thay vì đưa từng bản vá vào môi trường kiểm thử nặng nề, hệ thống sử dụng một mô hình ngôn ngữ làm giám khảo (LLM Judge) để so sánh đối đầu từng cặp bản vá ứng viên (pairwise comparison). Giám khảo sẽ phân tích sự khác biệt về logic giữa hai phương án để đưa ra kết luận bên nào triển vọng hơn.
- Khớp mô hình xác suất Bradley-Terry: Dựa trên kết quả so sánh đối đầu, khung SIFT áp dụng mô hình toán học Bradley-Terry có điều chuẩn để xếp hạng toàn bộ các bản vá trên một thang đo năng lực tổng thể. Thuật toán này giúp ước lượng xác suất thành công của từng phương án mà không cần kiểm thử độc lập mọi trường hợp.
- Tìm kiếm theo cây phân tán: Hệ thống triển khai cấu trúc tìm kiếm dạng cây phân tán (Disaggregated Tree Search). Tài nguyên kiểm thử toàn diện chỉ được phân bổ cho những nhánh ứng viên đứng đầu bảng xếp hạng xác suất, loại bỏ sớm các nhánh kém hiệu quả.
Kết quả thực nghiệm cho thấy khung SIFT giúp tác tử đạt độ chính xác 35,1% trên bộ tiêu chuẩn kiểm thử đa ngôn ngữ Polyglot benchmark, tương đương với phương pháp kiểm thử vét cạn truyền thống nhưng cắt giảm phần lớn thời gian và chi phí tính toán trên máy chủ.
3. Tác Động Và Rào Cản Thực Tế
Việc ứng dụng các mô hình lọc thống kê như SIFT vào quy trình phát triển tác tử lập trình mở ra triển vọng tự động hóa khâu tối ưu mã nguồn cho các tổ chức phần mềm, song cũng đặt ra những ranh giới kỹ thuật:
Giá Trị Thực Tiễn Đo Lường Được
- Tăng tốc độ lặp chu trình CI/CD: Các nền tảng phát triển phần mềm có thể tích hợp cơ chế lọc cặp để sàng lọc nhanh các đề xuất chỉnh sửa mã từ lập trình viên AI trước khi kích hoạt pipeline kiểm thử tích hợp chuyên sâu.
- Tiết kiệm ngân sách điện toán đám mây: Việc hạn chế tối đa các lần chạy container kiểm thử không cần thiết giúp doanh nghiệp kiểm soát chặt chẽ hóa đơn dịch vụ đám mây khi xây dựng các trợ lý lập trình nội bộ.
- Hỗ trợ tự động hóa bảo trì mã nguồn: Tác tử có thể vận hành thường trực trong kho mã nguồn để tự động rà soát, đề xuất và thẩm định các bản vá lỗi nhỏ mà không làm quá tải hạ tầng máy chủ nội bộ.
Rào Cản Và Sự Đánh Đổi Kỹ Thuật
- Phụ thuộc vào chất lượng giám khảo AI: Độ chính xác của thuật toán xếp hạng Bradley-Terry phụ thuộc trực tiếp vào tính khách quan của mô hình giám khảo. Nếu giám khảo bị suy luận sai lệch, các bản vá chất lượng có thể bị loại bỏ.
- Nguy cơ thiên kiến vòng tròn: Trong các bài toán phức tạp, sự so sánh giữa các cặp giải pháp có thể xuất hiện hiện tượng ưu tiên không bắc cầu (A thắng B, B thắng C nhưng C thắng A), đòi hỏi thuật toán điều chuẩn phải có cơ chế xử lý hợp lý.
- Yêu cầu tinh chỉnh theo từng miền nghiệp vụ: Một giám khảo AI được huấn luyện trên mã nguồn mở có thể không đánh giá chính xác các quy ước mã nguồn đặc thù của doanh nghiệp nếu chưa trải qua giai đoạn nạp ngữ cảnh chuyên sâu.
4. Góc Nhìn Từ NLTECH
Tại Việt Nam, khi các doanh nghiệp công nghệ ngày càng quan tâm đến việc ứng dụng AI Agent vào quy trình phát triển phần mềm thực chiến, bài toán tối ưu hóa chi phí vận hành và tài nguyên hạ tầng luôn là yếu tố quyết định tính khả thi của dự án. Khung kiến trúc SIFT từ MIT và Sakana AI minh chứng cho nguyên lý rằng việc xây dựng các công cụ đánh giá thông minh và áp dụng mô hình toán học phù hợp quan trọng không kém việc nâng cấp kích thước mô hình nền tảng. Sự kết hợp giữa các bộ lọc thống kê phản xạ nhanh và ranh giới kiểm thử tất định chính là nền tảng để xây dựng các giải pháp tự động hóa phần mềm bền vững và hiệu quả.