Liquid AI Công Bố Kiến Trúc LFM2.5-VL-DSpark: Tăng Tốc 3,13x Cho Vision-Language Model Bằng Speculative Decoding
Ngày 25/09/2026, Liquid AI công bố LFM2.5-VL-DSpark, tích hợp cơ chế Speculative Decoding vào mô hình thị giác ngôn ngữ 3B. Với mô hình nháp 280M chỉ chiếm 9% chi phí tính toán phụ trội, hệ thống tăng tốc giải mã 1,57x - 2,14x trên Apple Silicon và 2,27x - 3,13x trên GPU NVIDIA mà không làm giảm độ chính xác.
Ngày 25 tháng 09 năm 2026, phòng nghiên cứu Liquid AI đã chính thức công bố kiến trúc Liquid Foundation Model 2.5 Vision-Language tích hợp công nghệ DSpark (LFM2.5-VL-DSpark). Đây là giải pháp tích hợp cơ chế giải mã phỏng đoán (Speculative Decoding) vào mô hình thị giác kết hợp ngôn ngữ 3 tỷ tham số, cho phép các thiết bị biên như camera thông minh và máy tính nhúng tăng tốc độ xử lý từ 2,27 đến 3,13 lần mà không làm suy giảm chất lượng dữ liệu đầu ra.
1. Bối Cảnh Trước Khi Có Thay Đổi Này
Trong quá trình đưa các mô hình thị giác và ngôn ngữ lớn (Vision-Language Model - VLM) xuống thiết bị biên phục vụ phân tích camera thời gian thực, các kỹ sư hệ thống luôn đối mặt với bài toán nan giải về độ trễ và tài nguyên bộ nhớ. Khác với mô hình ngôn ngữ văn bản thông thường, mô hình thị giác đa phương thức phải xử lý khối lượng dữ liệu khổng lồ ngay từ khâu tiếp nhận:
Điểm Nghẽn Băng Thông Bộ Nhớ
Khi khung hình camera độ phân giải cao được nạp vào, bộ mã hóa thị giác (Vision Encoder) sẽ phân rã hình ảnh thành hàng trăm token không gian. Cùng với câu lệnh điều khiển, toàn bộ chuỗi token này được nạp vào mô hình chính. Trong giai đoạn sinh câu trả lời tự hồi quy, mô hình phải truy xuất lại toàn bộ bộ nhớ đệm khóa - giá trị (KV Cache) sau mỗi token sinh ra. Quá trình đọc bộ nhớ liên tục tạo ra hiện tượng nghẽn băng thông bộ nhớ (Memory Bandwidth Bottleneck), biến khâu giải mã thành tác vụ bị giới hạn bởi tốc độ truy xuất RAM thay vì năng lực tính toán thuần túy.
Sự Đánh Đổi Giữa Độ Trễ Và Chi Phí Vận Hành
Trên các thiết bị biên bị giới hạn điện năng như camera giám sát hay máy tính nhúng công nghiệp, độ trễ sinh từ của mô hình 3B thường kéo dài từ 3 đến 8 giây cho mỗi mô tả sự kiện. Để khắc phục độ trễ này, các giải pháp trước đây thường buộc phải lựa chọn giữa hai phương án đánh đổi:
- Lượng tử hóa quá mức: Ép trọng số mô hình xuống 3-bit hoặc 2-bit giúp giảm dung lượng RAM nhưng lại làm suy giảm khả năng nhận diện chi tiết nhỏ và dễ phát sinh ảo giác trong các tình huống an ninh phức tạp.
- Đẩy luồng video lên đám mây: Truyền toàn bộ luồng RTSP từ hàng loạt camera về cụm máy chủ trung tâm để chạy GPU. Cách làm này vừa làm phát sinh chi phí băng thông mạng lớn, vừa tiềm ẩn nguy cơ gián đoạn khi mất kết nối mạng và rủi ro về quyền riêng tư hình ảnh.
2. Chuyện Gì Vừa Thay Đổi
Theo thông báo kỹ thuật chính thức từ Liquid AI, bước tiến của kiến trúc LFM2.5-VL-DSpark nằm ở việc tích hợp thành công cơ chế giải mã phỏng đoán (Speculative Decoding) cho mô hình thị giác đa phương thức. Bộ trọng số mô hình đã được phát hành công khai trên mô hình LFM2.5-VL-3B-DSpark trên Hugging Face và bài phân tích kỹ thuật của Liquid AI, tương thích với thư viện MLX trên máy Mac, công cụ llama.cpp và SGLang trên GPU:
Cặp Mô Hình Ghép Đôi Dùng Chung Bộ Mã Hóa
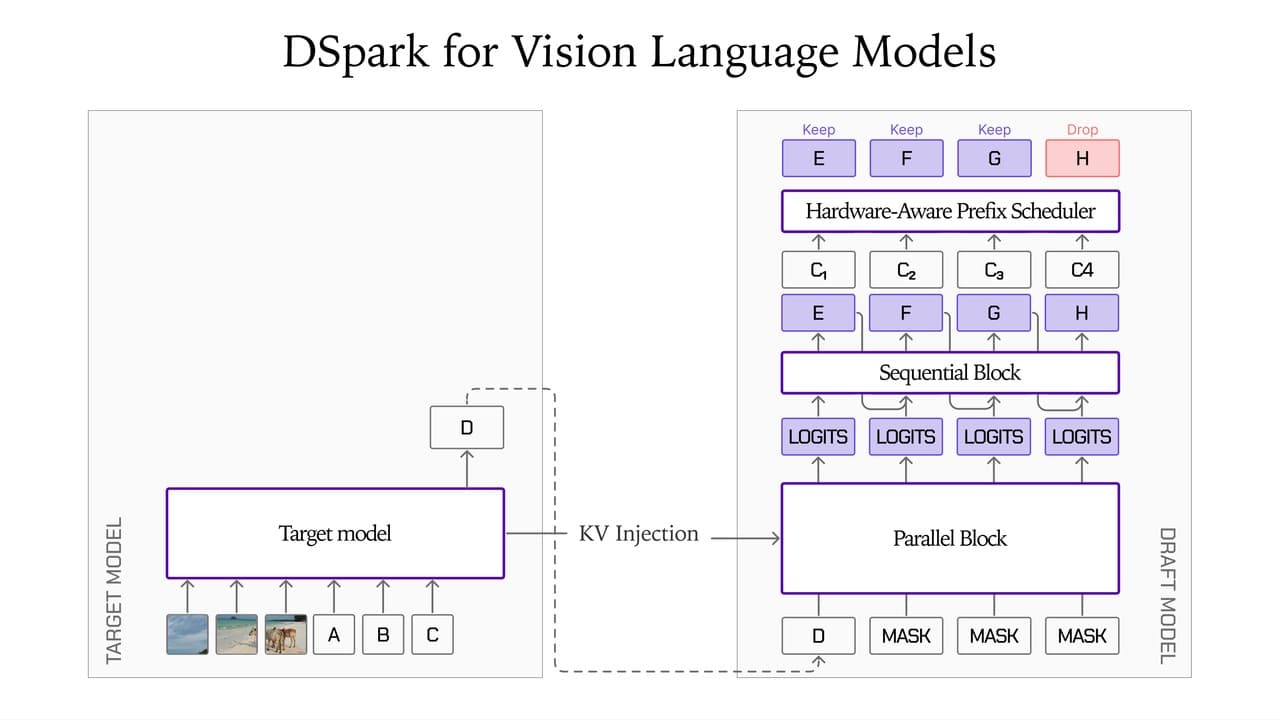
Hệ thống DSpark triển khai cấu trúc cộng tác nhịp nhàng giữa hai thành phần:
- Mô hình mục tiêu (Target Model): Mô hình chính LFM2.5-VL quy mô 3 tỷ tham số (3B), đảm nhiệm việc thấu hiểu hình ảnh sâu và giữ chất lượng suy luận cao.
- Mô hình phụ tá siêu nhẹ (Draft Model): Mạng nơ-ron chỉ có 280 triệu tham số (280M), được huấn luyện chuyên biệt để dự đoán trước chuỗi token tiếp theo dựa trên ngữ cảnh thị giác hiện tại. Chi phí tính toán phụ trội của mô hình phụ tá này chỉ chiếm dưới 9% so với mô hình mục tiêu.
Cả hai mô hình cùng chia sẻ chung một biểu diễn không gian từ bộ mã hóa thị giác, giúp việc xử lý hình ảnh chỉ cần thực hiện một lần mà không phải trích xuất đặc trưng lặp lại.
Luồng Xử Lý Song Song Và Tiêm Khóa Giá Trị
Quy trình suy luận của LFM2.5-VL-DSpark vận hành qua ba giai đoạn:
- Sinh chuỗi phỏng đoán (Draft Generation): Mô hình phụ tá 280M với tốc độ truy xuất bộ nhớ rất nhanh sẽ dự đoán trước một chuỗi gồm k token kế tiếp.
- Xác nhận song song một lượt (Single-Pass Verification): Mô hình mục tiêu 3B tiếp nhận chuỗi token dự đoán và xác minh song song trong một chu kỳ xung nhịp. Các token trùng khớp với phân phối xác suất sẽ được chấp thuận ngay lập tức.
- Điều phối cửa sổ theo phần cứng (Hardware-Aware Prefix Scheduler): Hệ thống tự động đo lường độ trễ phần cứng để linh hoạt điều chỉnh độ dài chuỗi dự đoán, tối ưu hóa giữa thời gian sinh nháp và thời gian xác nhận.
Dữ Liệu Kiểm Thử Hiệu Năng Thực Tế
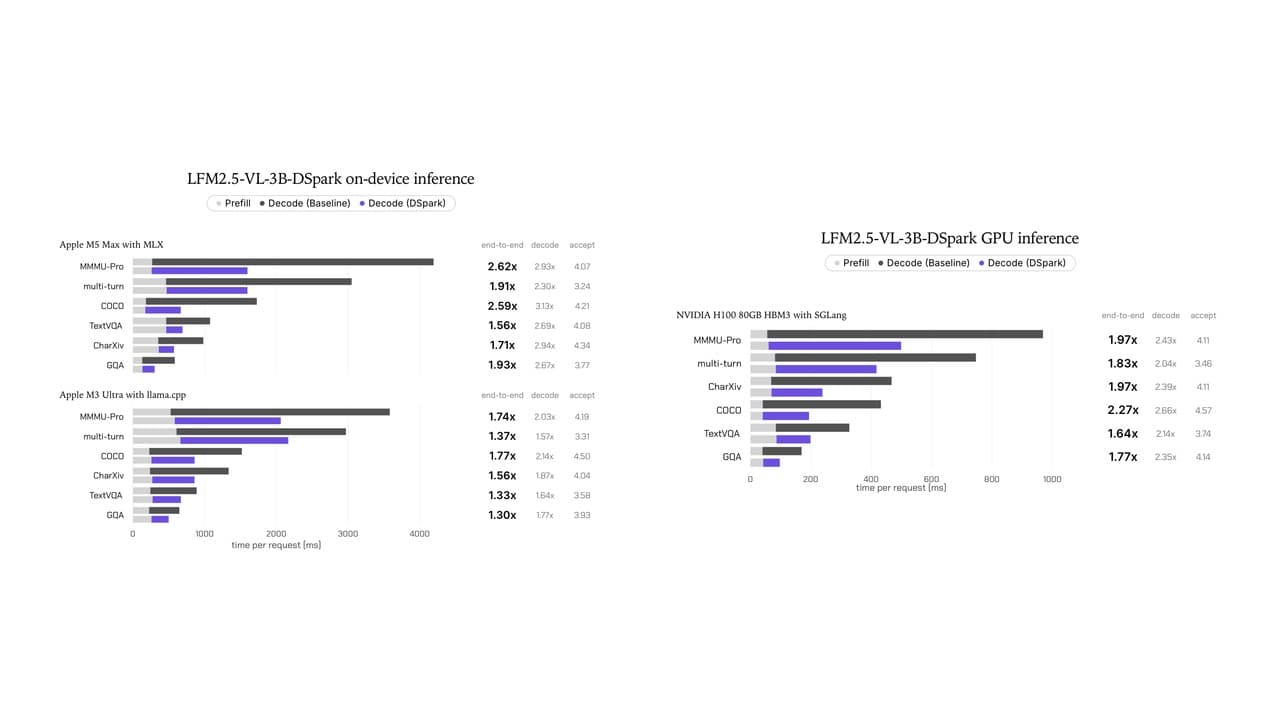
Các phép đo benchmark cho thấy kiến trúc DSpark cải thiện tốc độ rõ rệt trên nhiều phần cứng:
- Trên nền tảng Apple Silicon (qua MLX-VLM): Tốc độ giải mã thuần túy tăng từ 1,57 lần đến 2,14 lần; độ trễ toàn trình cải thiện từ 1,30 lần đến 1,77 lần.
- Trên GPU máy chủ (NVIDIA H100 qua SGLang): Tốc độ giải mã token đạt mức tăng từ 2,27 lần đến 3,13 lần; độ trễ toàn chu trình cải thiện từ 1,64 lần đến 2,27 lần.
- Bảo toàn độ chính xác: Dưới cơ chế giải mã tham lam (Greedy Decoding), các token được chấp thuận đều tương đương về mặt toán học với kết quả do mô hình 3B sinh ra độc lập, không xảy ra hiện tượng suy giảm chất lượng câu trả lời.
3. Tác Động Và Rào Cản Thực Tế
Việc ứng dụng cơ chế giải mã phỏng đoán cho mô hình thị giác mở ra nhiều hướng triển khai thực tế cho hệ thống camera giám sát, song cũng đi kèm các ràng buộc kỹ thuật cụ thể:
Cơ Hội Ứng Dụng Trong Giám Sát Cục Bộ
- Phản hồi tức thì trong phân tích sự cố: Với các camera lắp đặt tại nhà xưởng hay công trường, khả năng sinh mô tả sự kiện trong dưới 1 giây giúp phát hiện kịp thời các vi phạm an toàn lao động hoặc sự cố kỹ thuật ngay tại hiện trường.
- Tiết kiệm chi phí truyền tải: Các đơn vị vận hành camera có thể xử lý và tóm tắt sự kiện trực tiếp trên thiết bị biên, giúp giảm đáng kể lưu lượng dữ liệu cần tải về máy chủ trung tâm.
- Tương thích với định dạng mở: Việc hỗ trợ định dạng GGUF giúp các đội ngũ kỹ thuật dễ dàng thử nghiệm trên máy tính biên chạy kiến trúc ARM hoặc x86 tiêu chuẩn mà không đòi hỏi phần cứng chuyên dụng.
Rào Cản Kỹ Thuật Khi Triển Khai
- Yêu cầu dung lượng bộ nhớ kết hợp: Mặc dù mô hình phụ tá 280M tương đối nhẹ, thiết bị biên vẫn cần nạp đồng thời cả hai mô hình (khoảng 3,3 tỷ tham số) vào bộ nhớ RAM hợp nhất, đòi hỏi phần cứng biên phải có tối thiểu 6GB đến 8GB RAM khả dụng.
- Biến động của tỷ lệ chấp thuận token: Hiệu quả tăng tốc phụ thuộc vào mức độ tương đồng dự đoán giữa mô hình phụ tá và mô hình chính. Trong các khung cảnh ánh sáng thay đổi liên tục hoặc góc quay phức tạp, tỷ lệ chấp thuận token có thể sụt giảm, làm giảm mức tăng tốc thực tế.
- Quản lý tài nguyên đa tiến trình: Việc điều phối hai mô hình chạy song hành đòi hỏi hệ thống nhúng phải quản lý bộ nhớ đệm KV Cache chặt chẽ để tránh xung đột luồng hoặc phân mảnh tài nguyên.
4. Góc Nhìn Từ NLTECH
Tại thị trường Việt Nam, xu hướng chuyển dịch từ các thuật toán thị giác máy tính truyền thống sang các mô hình ngôn ngữ thị giác đa phương thức đang ngày càng rõ nét trong các giải pháp giám sát an ninh và quản trị công nghiệp. Tuy nhiên, rào cản lớn nhất khi đưa AI thị giác vào thực tế luôn nằm ở độ trễ xử lý và chi phí phần cứng biên. Công bố kỹ thuật LFM2.5-VL-DSpark từ Liquid AI chứng minh rằng việc kết hợp thông minh giữa các mô hình kích thước khác nhau và khai thác tối đa năng lực phần cứng có thể giải quyết bài toán hiệu năng mà không cần nâng cấp thiết bị tốn kém. Đây là cơ sở thực tiễn quan trọng để các doanh nghiệp công nghệ xây dựng những hệ thống phân tích camera tự hành mạnh mẽ, phản hồi nhanh và tối ưu chi phí vận hành lâu dài.