Microsoft Ra Mắt Bộ Ba MAI-Transcribe-2-Streaming Và MAI-Voice-2.1: Giảm Độ Trễ Kiosk AI Dưới 150ms Bằng Cơ Chế "Mua Lại Thời Gian"
Ngày 01/10/2026, Microsoft AI công bố MAI-Transcribe-2-Streaming (WER 2,5%, độ trễ 130ms, 60 ngôn ngữ) cùng bộ đôi MAI-Voice-2.1 và MAI-Voice-2.1-Flash (độ trễ 150ms, 23 ngôn ngữ với Single-Voice Identity). Kiến trúc này giúp Kiosk AI và Voice Bot phản hồi tức thì dưới 200ms bằng kỹ thuật truyền phát gối đầu.
Ngày 01 tháng 10 năm 2026, Microsoft AI đã chính thức công bố bộ ba mô hình xử lý giọng nói thời gian thực thế hệ mới gồm MAI-Transcribe-2-Streaming, MAI-Voice-2.1 và MAI-Voice-2.1-Flash. Đây là giải pháp kết hợp giữa công nghệ nhận diện giọng nói dạng luồng và tổng hợp giọng nói đa ngôn ngữ siêu tốc, cho phép các hệ thống Kiosk tự phục vụ và trợ lý thoại thông minh cắt giảm độ trễ phản hồi xuống dưới 150 mili-giây, tiệm cận tốc độ đối thoại tự nhiên của con người.
1. Bối Cảnh Trước Khi Có Thay Đổi Này
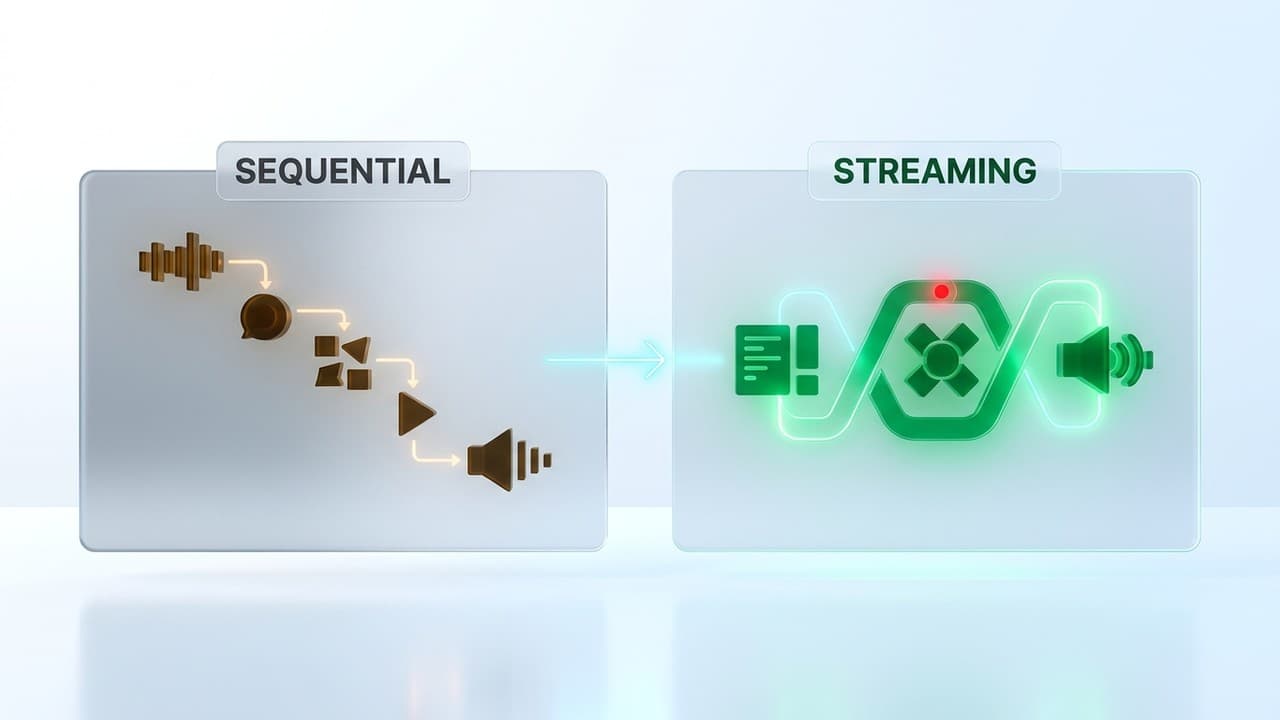
Trong quá trình triển khai các hệ thống Kiosk thông minh tại bệnh viện, sân bay hay trung tâm hành chính công, rào cản lớn nhất ảnh hưởng đến trải nghiệm của người dân luôn là độ trễ phản hồi trong các cuộc đàm thoại giọng nói. Dù các mô hình ngôn ngữ lớn ngày nay rất thông minh, phần lớn trợ lý thoại vẫn vận hành theo chuỗi tuần tự rời rạc:
Nút Thắt Độ Trễ Của Chuỗi Xử Lý Tuần Tự
Một lượt tương tác thông thường trên Kiosk tự phục vụ trải qua bốn giai đoạn nối tiếp nhau:
- Chờ nhận diện khoảng lặng: Hệ thống phải đợi người dùng ngừng nói và giữ khoảng lặng an toàn từ 400 đến 600 mili-giây để xác định câu nói đã kết thúc.
- Phiên âm toàn bộ âm thanh: Toàn bộ tệp âm thanh được gửi lên máy chủ để phiên âm thành văn bản, tiêu tốn từ 300 đến 500 mili-giây.
- Suy luận và gọi công cụ: Mô hình ngôn ngữ tiếp nhận văn bản, phân tích ý định và truy vấn cơ sở dữ liệu nghiệp vụ, mất khoảng 800 đến 1.200 mili-giây.
- Tổng hợp âm thanh phản hồi: Hệ thống nhận câu trả lời dạng chữ và chuyển đổi thành giọng nói để phát qua loa, tốn thêm 300 đến 500 mili-giây.
Tổng độ trễ cộng dồn của toàn bộ chu kỳ dao động từ 2 đến 3 giây. Khoảng lặng kéo dài này khiến người dùng tưởng rằng máy bị đơ, dẫn đến phản xạ cất lời hỏi lại đúng lúc hệ thống bắt đầu phát tiếng, gây ra hiện tượng xung đột âm thanh làm gián đoạn cuộc hội thoại.
Rào Cản Nhất Quán Về Danh Tính Giọng Nói Đa Ngôn Ngữ
Bên cạnh bài toán độ trễ, việc phục vụ du khách quốc tế tại các Kiosk công cộng cũng gặp thách thức lớn. Khi người dùng chuyển đổi ngôn ngữ từ tiếng Việt sang tiếng Anh hay tiếng Pháp, các hệ thống cũ thường phải đổi hoàn toàn sang một mô hình giọng khác. Sự thay đổi đột ngột về âm sắc này làm mất tính nhất quán thương hiệu, tạo cảm giác thiếu chuyên nghiệp trong dịch vụ khách hàng.
2. Chuyện Gì Vừa Thay Đổi
Theo Microsoft AI, thông tin chi tiết về bộ ba mô hình âm thanh mới đã được công bố chính thức qua cổng dịch vụ Microsoft Foundry và các tài liệu kỹ thuật trên nền tảng trí tuệ nhân tạo Microsoft. Điểm đột phá trong giải pháp của Microsoft là xóa bỏ cấu trúc xử lý tuần tự để chuyển sang mô hình luồng gối đầu thông qua cơ chế "Mua lại thời gian":
MAI-Transcribe-2-Streaming: Phiên Âm Liên Tục Dưới 130 Mili-Giây
Mô hình nhận diện giọng nói mới hoạt động theo thời gian thực thông qua kết nối truyền phát WebSocket:
- Phát giả định phiên âm sớm: Ngay khi người dùng cất tiếng nói, mô hình liên tục phát ra các giả định văn bản từng phần chỉ sau 100 đến 120 mili-giây, giúp hệ thống theo dõi nội dung song song với lời nói.
- Xác nhận bản thảo siêu tốc: Bản phiên âm chính xác cuối cùng được xác nhận chỉ khoảng 0,13 giây sau khi người dùng dứt lời, đạt tỷ lệ lỗi từ chỉ 2,5% và đứng đầu trên bảng xếp hạng kiểm chuẩn độc lập Artificial Analysis.
- Tự động nhận diện 60 ngôn ngữ: Mô hình hỗ trợ 60 ngôn ngữ và tự động phát hiện ngôn ngữ đang nói mà không cần cấu hình trước, rất phù hợp cho các điểm Kiosk đón tiếp đa quốc gia.
Cơ Chế "Mua Lại Thời Gian" Cho Mô Hình Ngôn Ngữ
Nhờ luồng văn bản được truyền về liên tục khi người dùng đang nói, mô hình ngôn ngữ phía sau có thể bắt đầu đọc hiểu ý định, chuẩn bị câu trả lời và gọi sẵn các API tra cứu thông tin ngay trong lúc người dùng chưa kết thúc câu. Quá trình tính toán của AI được gối đầu hoàn toàn vào khoảng thời gian phát biểu của con người, loại bỏ thời gian chờ đợi sau khi dứt lời.
Bộ Đôi Tổng Hợp Giọng Nói MAI-Voice-2.1 Và MAI-Voice-2.1-Flash
Đi kèm với mô hình phiên âm là hai giải pháp tổng hợp giọng nói:
- Danh tính giọng nói đơn nhất: Hỗ trợ 23 ngôn ngữ với khả năng giữ nguyên vẹn âm sắc đặc trưng của một giọng nói thương hiệu khi chuyển đổi qua lại giữa các ngôn ngữ khác nhau.
- Phiên bản Flash với độ trễ 150 mili-giây: MAI-Voice-2.1-Flash được tinh gọn đặc biệt cho các luồng đàm thoại tức thì, cho phép phát âm tiết đầu tiên chỉ trong 150 mili-giây kể từ khi nhận văn bản.
- Nhân bản giọng nói tức thì: Khả năng tái tạo giọng nói sống động từ đoạn ghi âm mẫu chỉ từ 5 đến 60 giây, đi kèm hệ thống kiểm soát quyền chấp thuận để ngăn ngừa các hành vi giả mạo.
3. Tác Động Và Rào Cản Thực Tế
Sự kết hợp giữa công nghệ phiên âm theo luồng và tổng hợp giọng nói độ trễ thấp mang lại bước tiến lớn cho giao tiếp người - máy, nhưng cũng đặt ra những lưu ý kỹ thuật khi đưa vào vận hành:
Lợi Ích Vận Hành Tại Các Điểm Chạm Tự Phục Vụ
- Nâng cao sự hài lòng tại Kiosk thông minh: Việc rút ngắn độ trễ phản hồi toàn chu trình xuống dưới 200 mili-giây mang lại cảm giác phản xạ tự nhiên như trò chuyện trực tiếp với nhân viên quầy, giúp người dân dễ dàng thao tác tra cứu thủ tục hành chính hay đặt lịch khám bệnh.
- Tối ưu hóa chi phí vận hành cho tổng đài tự động: Với mức giá công bố chỉ 0,54 USD cho mỗi giờ xử lý âm thanh nhận diện và 15 USD cho mỗi 1 triệu ký tự tổng hợp giọng nói, các đơn vị có thể triển khai hệ thống Voice Bot quy mô lớn với chi phí tiết kiệm hơn đáng kể so với việc duy trì tổng đài truyền thống.
- Xóa bỏ rào cản ngôn ngữ cho du khách: Các trạm thông tin tại sân bay và khách sạn có thể tự động nhận biết ngôn ngữ của du khách và phản hồi bằng chính giọng đọc đại diện thương hiệu quen thuộc.
Những Rào Cản Kỹ Thuật Khi Triển Khai Thực Tế
- Nhiễu âm thanh trong môi trường công cộng: Tại các sảnh Kiosk đông đúc, tiếng ồn ngoại cảnh có thể làm sai lệch các giả định phiên âm sớm. Để khắc phục, phần cứng Kiosk bắt buộc phải tích hợp hệ thống micro mảng định hướng và thuật toán khử nhiễu tại biên.
- Yêu cầu về độ ổn định của đường truyền mạng: Cơ chế truyền phát WebSocket đòi hỏi kết nối mạng Internet có độ trễ ổn định và độ biến thiên thời gian thấp để tránh giật cục luồng âm thanh.
- Nguy cơ an ninh từ việc nhân bản giọng nói: Tính năng sao chép giọng nói nhanh chóng từ mẫu âm thanh ngắn đòi hỏi các tổ chức phải áp dụng cơ chế xác thực sinh trắc học đa lớp để ngăn chặn nguy cơ giả mạo danh tính trong các giao dịch quan trọng.
4. Góc Nhìn Từ NLTECH
Tại thị trường Việt Nam, xu hướng hiện đại hóa các điểm giao dịch thông qua Kiosk thông minh và trợ lý giọng nói đang phát triển mạnh mẽ tại các bệnh viện, ngân hàng và trung tâm hành chính công một cửa. Tuy nhiên, rào cản lớn nhất khiến nhiều dự án chưa đạt kỳ vọng của người dân nằm ở cảm giác đàm thoại ngắt quãng và giọng đọc thiếu tự nhiên. Công bố kỹ thuật từ Microsoft với bộ giải pháp MAI Voice khẳng định rằng chìa khóa của giao tiếp AI không chỉ nằm ở trí thông minh của mô hình, mà nằm ở kiến trúc điều phối dòng dữ liệu theo thời gian thực để triệt tiêu độ trễ. Đối với các đơn vị phát triển phần mềm trong nước, việc nắm bắt và ứng dụng kịp thời các giải pháp giọng nói độ trễ thấp sẽ là bước đệm then chốt để xây dựng những hệ thống Kiosk tự phục vụ thực sự thân thiện, dễ tiếp cận cho mọi tầng lớp nhân dân và thúc đẩy công cuộc số hóa dịch vụ công bền vững.